Epidemiologie TP1 - R
contact: ludwig@univ-brest.fr
Epidémiologie TP1 - R
1. Introduction
R est un système d’analyse statistique et graphique créé par Ross Ihaka et Robert Gentleman. R est à la fois un logiciel et un langage qualifié de dialecte du langage S créé par AT&T Bell Laboratories. Il y a des différences importantes dans la conception de R et celle de S.
R est distribué librement sous les termes de la GNU General Public Licence; son développement et sa distribution sont assurés par plusieurs statisticiens rassemblés dans le R Development Core Team.
R comporte de nombreuses fonctions pour les analyses statistiques et les graphiques; ceux-ci sont visualisés immédiatement dans une fenêtre propre et peuvent être exportés sous divers formats (jpg, png, bmp, ps, pdf, emf, pictex, xfig ; les formats disponibles peuvent dépendre du système d’exploitation). Les résultats des analyses statistiques sont affichés à l’écran, certains résultats partiels (valeurs de P, coefficients de régression, résidus, . . .) peuvent être sauvés à part, exportés dans un fichier ou utilisés dans des analyses ultérieures.
Le langage R permet, par exemple, de programmer des boucles qui vont analyser successivement différents jeux de données. Il est aussi possible de combiner dans le même programme différentes fonctions statistiques pour réaliser des analyses plus complexes. Les utilisateurs de R peuvent bénéficier des nombreux programmes écrits pour S et disponibles sur internet, la plupart de ces programmes étant directement utilisables avec R.
De prime abord, R peut sembler trop complexe pour une utilisation par un non-spécialiste. Ce n’est pas forcément le cas. En fait, R privilégie la flexibilité. Alors qu’un logiciel classique affichera directement les résultats d’une analyse, avec R ces résultats sont stockés dans un “objet”, si bien qu’une analyse peut être faite sans qu’aucun résultat ne soit affiché. L’utilisateur peut être déconcerté par ceci, mais cette facilité se révèle extrêmement utile. En effet, l’utilisateur peut alors extraire uniquement la partie des résultats qui l’intéresse. Par exemple, si l’on doit faire une série de 20 régressions et que l’on veuille comparer les coefficients des différentes régressions, R pourra afficher uniquement les coefficients estimés : les résultats tiendront donc sur une ligne, alors qu’un logiciel plus classique pourra ouvrir 20 fenêtres de résultats. On verra d’autres exemples illustrant la flexibilité d’un système comme R vis-à-vis des logiciels classiques.
2. Prise en main
2.1. Lancer R
R
bash
2.2. Quitter R
> q()
r
3. Fonctionnement de R
R est un langage interprété, c'est-à-dire que les commandes tapées au clavier sont directement exécutées sans qu'il soit nécessaire de construire un programme.
La syntaxe de R se veut simple et intuitive. Avec R, une fonction, pour être exécutée, s'écrit toujours avec des parenthèses, même si elle ne contiennent pas d'argument (exemple ls()). Si l'utilisateur tape le nom de la fonction sans parenthèses, R affichera le contenu des instructions de cette fonction. Ex:
> plot
function (x, y, ...)
UseMethod("plot")
<bytecode: 0x2eefdd0>
<environment: namespace:graphics>
r
Quand R est utilisé, les variables, les données, les fonctions, les résultats, etc., sont stockés dans la mémoire de l’ordinateur sous forme d’objets qui ont chacun un nom. L’utilisateur va agir sur ces objets avec des opérateurs (arithmétiques, logiques, de comparaison, ...) et des fonctions (qui sont elles-mêmes des objets).
3.1 Opérations de base
L'affectation d'une valeur à un objet peut se faire de plusieurs façon équivalentes.
> a <- 1
> 2 -> b
> d = 3
r
pour afficher le contenu d'un objet on tape simplement son nom
> a
[1] 1
> b
[1] 2
> d
[1] 3
r
Si l'objet existe déjà, sa valeur précédente est effacée.
> n <- 5 + 7
> n
[1] 12
> n <- 6 * 8
> n
[1] 48
rTrouvez le résultat de cette liste de commandes. Puis tapez la pour vérifier
a <- 12
a <- a + 1
a <- a * 2
a <- a - 1
a
R
La fonction ls() donne la liste des objets en mémoire. ls.str() donne également le contenu de ces objets.
> ls()
[1] "a" "b" "d" "n"
> ls.str()
r
Pour obtenir de l'aide, on utilise ? ou help()
> ?ls
> help("ls")
r
4. Les objets
4.1. Simples Valeurs
R manipule des objets : ceux-ci sont caractérisés par leur nom et leur contenu, mais aussi par des attributs qui vont spécifier le type de données représenté par un objet. Considérons une variable qui prendrait les valeurs 1, 2 ou 3 : une telle variable peut représenter une variable entière (par exemple, le nombre d’oeufs dans un nid), ou le codage d’une variable catégorique (par exemple, le sexe de crustacés : 1=mâle, 2=femelle ou 3=hermaphrodite).
Le traitement de cette variable ne sera pas le même dans les deux cas : les attributs de l’objet donnent l’information nécessaire. Plus techniquement, l’action d’une fonction sur un objet va dépendre des attributs de celui-ci.
Les objets ont tous deux attributs : le mode et la longueur. Le mode est le type des éléments d’un objet; il en existe quatre principaux :
- numérique
- caractère
- complexe
- logique (
FALSEouTRUE).
D’autres modes existent qui ne représentent pas des données, par exemple fonction ou expression.
La longueur est le nombre d’éléments de l’objet. Pour connaître le mode et la longueur d’un objet on peut utiliser, respectivement, les fonctions mode, typeof et length :
> x <- 1
> mode(x)
[1] "numeric"
> typeof(x)
[1] "double"
> length(x)
[1] 1
> y <- as.integer(1)
> mode(y)
[1] "numeric"
> typeof(y)
[1] "integer"
> length(y)
[1] 1
> text="May the force be with you"
> mode(text)
[1] "character"
> typeof(text)
[1] "character"
> length(text)
[1] 1
> test=TRUE
> mode(test)
[1] "logical"
> length(test)
[1] 1
> cmp=2i+1
> mode(cmp)
[1] "complex"
> length(cmp)
[1] 1
r
Dans tous ces exemple, la longueur est toujours 1. Mais R peut également manipuler des objets plus complexes, comme des vecteurs.
> v <- c(17,-2.3)
> v
[1] 17.0 -2.3
> mode(v)
[1] "numeric"
> typeof(v)
[1] "double"
> length(v)
[1] 2
r- Quelque soit le mode, les valeurs manquantes sont représentées par
NA(not available). - Une valeur numérique très grande peut être spécifiée avec une notation exponentielle.
- Les valeurs
Infet-Inf. - Les résultats qui ne sont pas des nombres valides sont représentés par
NaN(Not a Number).
> N <- 2.1e23
> N
[1] 2.1e+23

> x <- 5/0
> x
[1] Inf

> exp(x)
[1] Inf

> exp(-x)
[1] 0

> x - x
[1] NaN
r
4.2. Vecteurs
On crée un vecteur avec la fonction c (*concatenate*).
> c(1 ,2.6, 47, 98, 44.4)
[1]  1.0  2.6 47.0 98.0 44.4
r
il est possible d'isoler une ou plusieurs valeurs d'un vecteur avec [] en précisant les indices à retenir
> v <- c(1 ,2.6, 47, 98, 44.4)
> v[2]
[1] 2.6
> v[2:4]
[1]  2.6 47.0 98.0
> v[1] <- 1.1
> v
[1]  1.1  2.6 47.0 98.0 44.4
r
on peut faire des opérations arithmétiques sur l'ensemble d'un vecteur
> v + 1
> v * 2
> v / 10
R
on peut appliquer certaines fonctions sur un vecteur
> sum(v) #somme tous les éléments d'un vecteur
[1] 193.1
> prod(v) #multiplie entre eux les éléments d'un vecteur
[1] 584888.3
> mean(v)
[1] 38.62
> median(v)
[1] 44.4
> max(v)
[1] 98
R
il est aussi possible de concaténer deux vecteurs
> v1 <- c(1,3)
> v2 <- c(3,7)
> c(v1,v2)
[1] 1 3 3 7
> c(v1,2:8,v2)
[1] 1 3 2 3 4 5 6 7 8 3 7
r
4.3. Matrices
Les matrices peuvent être créées avec la fonction matrix. Ici une matrix de 10 éléments, répartis sur 5 colonnes.
> A <- matrix( 1:10, ncol=5)
> A
[,1] [,2] [,3] [,4] [,5]
[1,] 1 3 5 7 9
[2,] 2 4 6 8 10
r
Comme pour les vecteurs, il est possible d’extraire une valeur, une ligne ou une colonne avec [ligne,colonne].
> A[1,4] #élément à la ligne 1/colonne 4
[1] 7
> A[2,] #ligne 2, sous la forme d'un vecteur
> A[2, , drop=FALSE] #ligne 2, sous la forme d'une matrice
[,1] [,2] [,3] [,4] [,5]
[1,] 2 4 6 8 10

r📝 l’option drop=FALSE permet de garder le résultat sous forme de matrice et non de vecteur.
Transposer une matrice
> t(A)
    [,1] [,2]
[1,]    1    2
[2,]    3    4
[3,]    5    6
[4,]    7    8
[5,]    9   10

R
Produit de Matrice (avec %*%)
t(A) %*% A
     [,1] [,2] [,3] [,4] [,5]
[1,]    5   11   17   23   29
[2,]   11   25   39   53   67
[3,]   17   39   61   83  105
[4,]   23   53   83  113  143
[5,]   29   67  105  143  181
R
Inverse (avec solve)
M <- matrix( c(2,2,3, 1,2,3, -2,3,4), nrow=3)
> solve(M)
     [,1] [,2] [,3]
[1,]    1   10   -7
[2,]   -1  -14   10
[3,]    0    3   -2
> solve(M) %*% M
     [,1] [,2] [,3]
[1,]    1    0    0
[2,]    0    1    0
[3,]    0    0    1
R
Déterminant (avec det)
> det(M)
[1] -1
R
Diagonale d'une matrice (avec diag())
> diag(M)
[1] 2 2 4
R
Créer une matrice diagonale
> diag(c(2,4,8))
[,1] [,2] [,3]
[1,] 2 0 0
[2,] 0 4 0
[3,] 0 0 8
R
Trace d'une matrice
> sum(diag(M))
[1] 8
R
4.4. Listes
les listes d'objets peuvent être créées avec la fonction list(). Les objects contenus dans les listes peuvent être de mode/type différents.
`
> l <- list(Prenom=c("Ophelie", "Annabelle"), Nom="Dupont", Age=23)
> l
$Prenom
[1] "Ophelie" "Annabelle"
$Nom
[1] "Dupont"
$Age
[1] 23
r
les objets contenus dans la liste peuvent être extraits avec $.
> l$Prenom
[1] "Ophelie" "Annabelle"
r
4.5. Dataframes
Un DataFrame est une liste particulière.
- c'est une liste de vecteurs de données
- ces vecteurs sont de même longueur
- ces vecteurs peuvent être nommés
- les lignes peuvent également être nommées
- on peut manipuler un dataframe comme une matrice, par indices
[ligne, colonne]
> annee <- c(1995,2001,1987,2000)
> taille <- c(172,153,190,168)
> sexe <- c("M","F","M",NA)
> frame <- data.frame(list(annee, taille, sexe))
> colnames(frame) <- c("Année","Taille","Sexe")
> rownames(frame) <- c("Eric", "Diane", "Michael", "Alex")
r
on peut obtenir des informations sur le data frame
> frame
        Année Taille Sexe
Eric     1995    172    M
Diane    2001    153    F
Michael  1987    190    M
Alex     2000    168 <NA>

> class(frame)
[1] "data.frame"

> summary(frame)
     Année          Taille        Sexe
 Min.   :1987   Min.   :153.0   F   :1
 1st Qu.:1993   1st Qu.:164.2   M   :2
 Median :1998   Median :170.0   NA's:1
 Mean   :1996   Mean   :170.8
 3rd Qu.:2000   3rd Qu.:176.5
 Max.   :2001   Max.   :190.0
r
Accès aux variables
> ## les commandes suivantes sont équivalentes
> frame$Année #par nom
> frame[[1]] #format liste
> frame[,1] #format matrice
> frame[["Année"]]
> frame[,"Année"]
[1] 1995 2001 1987 2000

> frame[1] # par num.col
> frame["Année"]
        Année
Eric     1995
Diane    2001
Michael  1987
Alex     2000
r
Accès aux individus
> frame[1,]
     Année Taille Sexe
Eric  1995    172    M
> frame[c(1,3),]
        Année Taille Sexe
Eric     1995    172    M
Michael  1987    190    M
> frame["Diane",]
      Année Taille Sexe
Diane  2001    153    F
> frame[c(1,3),2:3]
        Taille Sexe
Eric       172    M
Michael    190    M
> frame[c("Eric","Diane"), c("Année","Sexe")]
      Année Sexe
Eric   1995    M
Diane  2001    F
r
5. Lire des données dans un fichier
Pour les lectures et écritures dans les fichiers, R utilise le répertoire de travail. Pour connaître ce répertoire, on peut utiliser la commande getwd() (get working dirctory). Il est possible de changer ce répertoire avec setwd("/NOUVEAU/REPERTOIRE").
R peut lire des données stockés dans des fichiers texte à l'aide de la fonction read.table()
La fonction read.table() a pour effet de créer un Data Frame et est donc le moyen principal pour lire des fichiers de données. Par exemple, si on a un fichier nommé data.dat, la commande
> mydata <- read.table("data.dat")
r
créera un tableau de données nommé mydata, et les variables, par défaut nommés V1,V2,...,Vn, pourront être accédées individuellement par
mydata$V1,mydata$V2,...,mydata$Vnoumydata["V1"],mydata["V2"],...,mydata["Vn"], ou encoremydata[, 1],mydata[, 2],...,mydata[, n].
Il y a plusieurs options dont voici les valeurs par défaut (c'est à dire celles utilisés par R si elles sont omises par l'utilisateur).
read.table(file, header = FALSE, sep = "", quote = "'", dec = ".",
	row.names, col.names, as.is = FALSE, na.strings = "NA",
	colClasses = NA, nrows = -1,
	skip = 0, check.names = TRUE, fill = !blank.lines.skip,
	strip.white = FALSE, blank.lines.skip = TRUE,
	comment.char = "#")
r| Option | Description |
|---|---|
file |
le nom du fichier (entre "" ou une variable de mode caractère), éventuellement avec son chemin d’accès (le symbole \ est interdit et doit être remplacé par /, même sous Windows), ou un accès distant à un fichier de type URL (http://...) |
header |
une valeur logique (FALSE ou TRUE indiquant si le fichier contient les noms des variables sur la 1 |
sep |
le séparateur de champ dans le fichier, par exemple sep="\t" si c’est une tabulation |
quote |
les caractères utilisés pour citer les variables de mode caractère |
dec |
le caractère utilisé pour les décimales |
row.names |
un vecteur contenant les noms des lignes qui peut être un vecteur de mode character, ou le numéro (ou le nom) d’une variable du fichier (par défaut : 1, 2, 3, ...) |
col.names |
un vecteur contenant les noms des variables (par défaut : V1, V2, V3, ...) |
as.is |
contrôle la conversion des variables caractères en facteur (si FALSE) ou les conserve en caractères (si TRUE) ; as.is peut être un vecteur logique, numérique ou caractère précisant les variables conservées en caractère |
na.strings |
indique la valeur des données manquantes (sera converti en NA) |
colClasses |
un vecteur de caractères donnant les classes à attribuer aux colonnes |
nrows |
le nombre maximum de lignes à lire (les valeurs négatives sont ignorées) |
skip |
le nombre de lignes à sauter avant de commencer la lecture des données |
check.names |
si TRUE, vérifie que les noms des variables sont valides pour R |
fill |
si TRUE et que les lignes n’ont pas tous le même nombre de variables, des blancs sont ajoutés |
strip.white |
(conditionnel à sep) si TRUE, efface les espaces (= blancs) avant et après les variables de mode caractère |
blank.lines.skip |
si TRUE, ignore les lignes blanches |
comment.char |
un caractère qui définit des commentaires dans le fichier de données, la lecture des données passant à la ligne suivante (pour désactiver cet option, utiliser comment.char = "") |
6. Merge
La fonction merge() permet de joindre deux tables sur une clé (colonne) identique. Par défaut, la fonction renvoie l'intersection des deux tables, mais il est également possible d'obtenir l'union des tables, ou de compléter les données d'une des tables.
> t1 <- read.table("/home/tludwig/master2ggb/table1.tsv", header=TRUE)
> t1
         Nom Age Sexe
1     Emilie  23    F
2       Jean  21    H
3 Christophe  23    H
4      Marie  21    F
5     Pierre  25    H
6     Sophie  24    F

> t2 <- read.table("/home/tludwig/master2ggb/table2.tsv", header=TRUE)
> t2
   Prenom    Ville
1   Aline   Angers
2    Jean    Brest
3 Caradoc   Vannes
4   Marie    Brest
5  Sophie Bordeaux
6  Marcel Toulouse

> merge(x=t1,y=t2,by.x="Nom",by.y="Prenom")
     Nom Age Sexe    Ville
1   Jean  21    H    Brest
2  Marie  21    F    Brest
3 Sophie  24    F Bordeaux

> merge(x=t1,y=t2,by.x="Nom",by.y="Prenom",all=TRUE)
         Nom Age Sexe    Ville
1 Christophe  23    H     <NA>
2     Emilie  23    F     <NA>
3       Jean  21    H    Brest
4      Marie  21    F    Brest
5     Pierre  25    H     <NA>
6     Sophie  24    F Bordeaux
7      Aline  NA <NA>   Angers
8    Caradoc  NA <NA>   Vannes
9     Marcel  NA <NA> Toulouse

> merge(x=t1,y=t2,by.x="Nom",by.y="Prenom",all.x=TRUE)
         Nom Age Sexe    Ville
1 Christophe  23    H     <NA>
2     Emilie  23    F     <NA>
3       Jean  21    H    Brest
4      Marie  21    F    Brest
5     Pierre  25    H     <NA>
6     Sophie  24    F Bordeaux


> merge(x=t1,y=t2,by.x="Nom",by.y="Prenom",all.y=TRUE)
      Nom Age Sexe    Ville
1    Jean  21    H    Brest
2   Marie  21    F    Brest
3  Sophie  24    F Bordeaux
4   Aline  NA <NA>   Angers
5 Caradoc  NA <NA>   Vannes
6  Marcel  NA <NA> Toulouse

r
7. Enregistrer les données dans un fichier
La fonction write.table écrit dans un fichier un objet, typiquement un tableau de données, mais cela peut bien être un autre type d'objet (vecteur, matrice, ...). Les arguments et options sont :
write.table(x, file = "", append = FALSE, quote = TRUE, sep = " ",
	eol = "\n", na = "NA", dec = ".", row.names = TRUE,
	col.names = TRUE, qmethod = c("escape", "double"))
r| Option | Description |
|---|---|
x |
le nom de l’objet écrire |
file |
le nom du fichier (par défaut l’objet est affiché à l’écran) |
append |
si TRUE ajoute les données sans effacer celles éventuellement existantes dans le fichier |
quote |
une variable logique ou un vecteur numérique : si TRUE les variables de mode caractère et les facteurs sont écrits entre "", sinon le vecteur indique les numéros des variables à écrire entre "" (dans les deux cas les noms des variables sont écrits entre "" mais pas si quote = FALSE) |
sep |
le séparateur de champ dans le fichier |
eol |
le caractère imprimé à la fin de chaque ligne ("\n" correspond à un retour chariot) |
na |
indique le caractère utilisé pour les données manquantes |
dec |
le caractère utilisé pour les décimales |
row.names |
une variable logique indiquant si les noms des lignes doivent être écrits dans le fichier |
col.names |
idem pour les noms des colonnes |
qmethod |
spécifie, si quote=TRUE, comment sont traitées les guillemets doubles " incluses dans les variables de mode caractère : si "escape" (ou "e", le défaut) chaque " est remplacée par \", si "d" chaque " est remplacée par "" |
Pour écrire de façon plus simple un objet dans un fichier, on peut utiliser la commande write.table(x, file="data.txt") où x est le nom de l'objet.
> results <- merge(x=t1,y=t2,by.x="Nom",by.y="Prenom",all=TRUE)
> write.table(results, file="results.tsv", quote=FALSE, sep="\t")
R
8. Selection dans un vecteur
Il est possible de filtrer un tableau pour ne garder que certaines valeurs.
> results
         Nom Age Sexe
1     Emilie  23    F
2       Jean  21    H
3 Christophe  23    H
4      Marie  21    F
5     Pierre  25    H
6     Sophie  24    F

> subset(results, results$Sexe == "F")
     Nom Age Sexe
1 Emilie  23    F
4  Marie  21    F
6 Sophie  24    F

> median(results[results$Age < 24, "Age"])
[1] NA

> median(results[results$Age < 24, "Age"], na.rm=TRUE)
[1] 22
r
9. Générer des données
9.1. Séquences régulières
Tous les nombres de 1 à 30
> x <- 1:30
r- On a ainsi un vecteur
xavec 30 éléments. - L'opérateur
:est prioritaire sur les opérations arithmétiques au sein d'une expression :
> 1:10-1
[1] 0 1 2 3 4 5 6 7 8 9
> 1:(10-1)
[1] 1 2 3 4 5 6 7 8 9
r
La fonction seq peut générer des séquences de nombres réels de la manière suivante ;
> seq(1, 5, 0.5)
[1] 1.0 1.5 2.0 2.5 3.0 3.5 4.0 4.5 5.0
r
où le premier nombre indique le début de la séquence, le second la fin, et le troisième l'incrément.
La fonction rep crée un vecteur qui aura tous ses éléments identiques :
> rep(1, 30)
[1] 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
r
9.2. Séquences aléatoires
Il est utile en statistique de pouvoir générer des données aléatoires, et R peut le faire pour un grand nombre de fonctions de densité de probabilité. Ces fonctions sont de la form rfunc(n, p1, p2, ..., pn), où func indique la loi de probabilité, n le nombre de données générées et p1, p2, ..., pn sont les valeurs des paramètres de la loi.
| loi | fonction |
|---|---|
| Gauss (normale) | rnorm(n, mean=0, sd=1) |
| exponentielle | rexp(n, rate=1) |
| gamma | rgamma(n, shape, scale=1) |
| Poisson | rpois(n, lambda) |
| Weibull | rweibull(n, shape, scale=1) |
| Cauchy | rcauchy(n, location=0, scale=1) |
| beta | rbeta(n, shape1, shape2) |
| Student (t) | rt(n, df) |
| Fisher–Snedecor (F) | rf(n, df1, df2) |
| Pearson ( |
rchisq(n, df) |
| binomiale | rbinom(n, size, prob) |
| multinomiale | rmultinom(n, size, prob) |
| géométrique | rgeom(n, prob) |
| hypergéométrique | rhyper(nn, m, n, k) |
| logistique | rlogis(n, location=0, scale=1) |
| lognormale | rlnorm(n, meanlog=0, sdlog=1) |
| binomiale négative | rnbinom(n, size, prob) |
| uniforme | runif(n, min=0, max=1) |
| statistiques de Wilcoxon | rwilcox(nn, m, n), rsignrank(nn, n) |
10. Statistiques
R est un langage de programmation avant tout utilisé pour sa puissance dans le domaine des statistiques.
Nous verrons quelques fonctions de base dans ce domaine.
> v <- (sample.int(101,size=100,replace=TRUE)-1)/100 # 100 nombre entre 0 et 1 arondi à 2 décimales
> max(v)
[1] 1
> min(v)
[1] 0
> mean(v)
[1] 0.5852
> median(v)
[1] 0.65
> quantile(v, .33)
   33%
0.4567
> quantile(v, c(.1,.2,.3,.4,.5,.6,.7,.8,.9))
  10%   20%   30%   40%   50%   60%   70%   80%   90%
0.139 0.332 0.440 0.536 0.650 0.718 0.796 0.852 0.931
> sum(v)
[1] 58.52
> sum(v >= 0.75) # combien de valeur >= 0.75 ?
[1] 37
> var(v) #variance
[1] 0.08217067
> sd(v) # standard deviation
[1] 0.2866543
> summary(v)
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
 0.0000  0.3925  0.6500  0.5852  0.8400  1.0000
> library(Hmisc)
> describe(v)
       n  missing distinct     Info     Mean      Gmd      .05      .10
     100        0       61        1   0.5852   0.3277   0.0890   0.1390
     .25      .50      .75      .90      .95
  0.3925   0.6500   0.8400   0.9310   0.9600
lowest : 0.00 0.02 0.03 0.07 0.09, highest: 0.95 0.96 0.97 0.98 1.00

> table(v) # valeurs et nombre d'occurrences

# en regardant les sortie de v et diff(v), que fait la fonction diff ?
> v
> diff(v)
r
11. Graphiques
R propose plusieurs fonctions pour générer des graphiques.
11.1. Affichage d'une fonction mathématique
On affiche, pour
> y=function(x){3*x*cos(x)*log(x+20)-12*sin(x)+100}
> plot(y,xlim=c(-10,10))
r
11.2 Scatter Plot et Regression Linéaire
Comparons le nombre de fois où un personnage parle dans Harry Potter and the Philosopher's Stone et Harry Potter and the Prisoner of Azkaban
11.2.1 Préparation des données
# chargement des données
hp1 <- read.table("/home/tludwig/master2ggb/hp1.tsv", header=TRUE)
hp3 <- read.table("/home/tludwig/master2ggb/hp3.tsv", header=TRUE)
# fusion des 2 tableaux
dialog=merge(hp1,hp3,by="Who", all=TRUE)
dialog

# Le contenu de la colonne "Who" devient le nom des lignes
rownames(dialog)<-dialog$Who

# On remplace les données manquantes par des 0
dialog[is.na(dialog)] <- 0
plot(dialog$HP1, dialog$HP3,xlab="Lines in Philosopher's Stone",ylab="Lines in Azkaban")
R
11.2.2 Regression Linéaire
On utilise la fonction lm() pour obtenir la régression linéaire.
reg <- lm(formula = dialog$HP1 ~ dialog$HP3, data = dialog)
reg
summary(reg)
abline(reg)
R
11.2.3 Affichage du nuage de points en trompette (Residuals vs Fitted)
plot(reg, which=1)
R
Lupin, Ron et Hagrid sont les principaux outliers
11.2.4 Affichage de la normalité des résidus
plot(reg, which=2)
R
Dans le 3e livre Lupin a trop de dialogues, alors qu'on en attendait plus de Harry et Hagrid
11.2.5 Affichage de la distance de Cook
La distance de Cook mesure l’influence d’une observation sur le modèle. Plus elle est élevée, plus cette
observation influence les valeurs prédites pour les autres points.
plot(reg, which=4)
R
Sans surpris, c'est Lupin, Harry, Ron et Hagrid qui ont le plus d'influence sur le modèle.
11.2.6 Sans données manquantes
Si l'on fait la même analyse avec uniquement les personnages présents dans les 2 livres :
dialog2=merge(hp1,hp3,by="Who")
dialog2

rownames(dialog2)<-dialog2$Who
dialog2[is.na(dialog2)] <- 0
plot(dialog2$HP1, dialog2$HP3,xlab="Lines in Philosopher's Stone",ylab="Lines in Azkaban")
reg2 <- lm(formula = dialog2$HP1 ~ dialog2$HP3, data = dialog2)
reg2
abline(reg2)

plot(reg2, which=1)

plot(reg2, which=2)

plot(reg2, which=4)
R
11.3 Distributions et Histogrammes
On va tirer une distribution de 1 million de valeurs.
11.3.1 Distribution uniforme
S=1000000
unif <- runif(S)
hist(unif, breaks=20)

# on a environ 500 valeurs dans chacune des 20 barres (20x5000 = 1 000 000)
hist(unif, breaks=1000)
R
11.3.2 Loi Normale
norm <- rnorm(S)
hist(norm, breaks=20)

hist(norm, breaks=1000)
R
11.3.3 Loi Géométrique
geom <- rgeom(S)
hist(geom, breaks=20)

hist(geom, breaks=1000)
R
11.3.4 Estimation de PI
Ici on va cherche à établir une estimation de la valeur de
- On tire aléatoirement un grand nombre de points dans le carré qui encadre un cercle de rayon 1 et centré sur
- On regarde combien des points du carré sont également dans le cercle.
On tire S points dont les coordonnés
S=10000
points <- data.frame(x=runif(S)*2-1, y=runif(S)*2-1)
plot(points)
R
On ajoute in colonne inside qui indique si le point est à l'intérieur du cercle de centre
Cette condition est vrai si
points$inside=(points$x**2 + points$y**2 <= 1)
# en R ** indique une puissance
R
On affiche en noir les points à l'extérieur du cercle (inside == FALSE) et en rouge ceux à l'intérieur (inside == TRUE)
plot(points$x, points$y, col=ifelse(points$inside,"red","black"))
R
On compte le nombre de points à l'intérieur du cercle
C = length(points$inside[points$inside == TRUE])
- L'aire du carré est
- L'aire du cercle est
- Comme
- En suivant une distribution uniforme, il devrait donc y avoir
- En reprenant nos variables S et C,
- on peut donc approximer
4*C / S
R
Reprenons avec 10 million de points (⚠ mais sans faire de plot ⚠). L'estimation devrait être plus précise.
S=10000000
points <- data.frame(x=runif(S)*2-1, y=runif(S)*2-1)
points$inside=(points$x**2 + points$y**2 <= 1)
C = length(points$inside[points$inside == TRUE])
4*C / S
R
11.4. Pie Chart
data=c(5,5,20,70)
colors=c("lightblue","pink","lightyellow1","palegreen")
cat=c("Say: I can't hear you","Move closer so I can hear","Repeatedly shout: WHAT?!!","Laugh and hope it wasn't a question")
pie(data,main="What I do when I can't hear someone", col=colors, labels=data, cex=0.8)
legend(-2.0,-0.5, cat, cex=0.8, fill=colors)
r
11.5 Box plot
simpsons=read.table("/home/tludwig/ns.location.line.tsv", header=T, sep="\t")
locations=unique(simpsons$Location)
indices=seq(length(locations))
colors=c("#4E79A7","#F28E2B","#E15759","#76B7B2","#59A14F","#EDC948","#B07AA1","#9C755F","#BAB0AC","#FF9DA7")

boxplot(Lines ~ Location, data=simpsons, col=colors, main="Number of Lines spoken per Episode", names=indices)
legend(0.5,220, paste(indices,"-",locations), cex=0.8, fill=colors)
r
11.6. Export d'un graphique dans une image
Il est possible d'exporter un graphique dans un fichier (png, jpg, pdf...) au lieu de l'afficher à l'écran.
- La commande
png()permet de créer le fichier, en spécifiant son nom (ainsi que sa taille, la couleur du fond, ...) - Ensuite on passe toutes les commandes relatives au graphiques
- On termine par
dev.off(). Cela indique que le fichier peut maintenant être écrit sur le disque
age <- read.table("/home/tludwig/master2ggb/age.tsv")
png(filename = "monhistogramme.png", bg = "white")
hist(age$V1, breaks=seq(0,330,by=15) )
dev.off()
r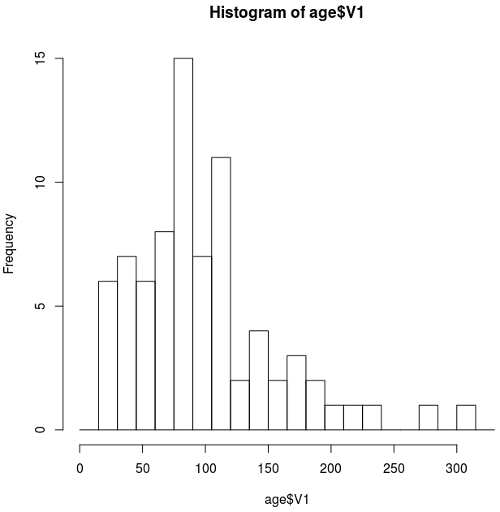
11.7. Les Fonctions graphiques
| Fonction | Description |
|---|---|
plot(x) |
graphe des valeurs de x (sur l’axe des y) ordonnées sur l’axe des x |
plot(x, y) |
graphe bivarié de x (sur l’axe des x) et y (sur l’axe des y) |
sunflowerplot(x,y) |
idem que plot() mais les points superposés sont dessinés en forme de fleurs dont le nombre de pétales représente le nombre de points |
pie(x) |
graphe en camembert |
boxplot(x) |
graphe boites et moustaches |
stripchart(x) |
graphe des valeurs de x sur une ligne (une alternative à boxplot() pour des petits échantillons) |
coplot(x~y \| z) |
graphe bivarié de x et y pour chaque valeur (ou intervalle de valeurs) de z |
interaction.plot(f1,f2,y) |
si f1 et f2 sont des facteurs, graphe des moyennes de y (sur l’axe des y) en fonction des valeurs de f1 (sur l’axe des x) et de f2 (différentes courbes) ; l’option fun permet de choisir la statistique résumée de y (par défaut fun=mean) |
matplot(x,y) |
graphe bivarié de la 1x contre la 1y, la 2x contre la 2y, etc. |
dotchart(x) |
si x est un tableau de données, dessine un graphe de Cleveland (graphes superposés ligne par ligne et colonne par colonne) |
fourfoldplot(x) |
visualise, avec des quarts de cercles, l’association entre deux variables dichotomiques pour différentes populations (x doit être un tableau avec dim=c(2, 2, k) ou une matrice avec dim=c(2, 2) si k = 1) |
assocplot(x) |
graphe de Cohen–Friendly indiquant les déviations de l’hypothèse d’indépendance des lignes et des colonnes dans un tableau de contingence à deux dimensions |
mosaicplot(x) |
graphe en mosaïque des résidus d’une régression log-linéaire sur une table de contingence |
pairs(x) |
si x est une matrice ou un tableau de données, dessine tous les graphes bivariés entre les colonnes de x |
plot.ts(x) |
si x est un objet de classe "ts", graphe de x en fonction du temps, x peut être multivarié mais les séries doivent avoir les mêmes fréquence et dates |
ts.plot(x) |
idem mais si x est multivarié les séries peuvent avoir des dates différentes et doivent avoir la même fréquence |
hist(x) |
histogramme des fréquences de x |
barplot(x) |
histogramme des valeurs de x |
qqnorm(x) |
quantiles de x en fonction des valeurs attendues selon une loi normale |
qqplot(x, y) |
quantiles de y en fonction des quantiles de x |
contour(x, y, z) |
courbes de niveau (les données sont interpolées pour tracer les courbes), x et y doivent être des vecteurs et z une matrice telle que dim(z)=c(length(x), length(y)) (x et y peuvent être omis) |
filled.contour (x, y, z) |
idem mais les aires entre les contours sont colorées, et une légende des couleurs est également dessinée |
image(x, y, z) |
idem mais les données sont représentées avec des couleurs |
persp(x, y, z) |
idem mais en perspective |
stars(x) |
si x est une matrice ou un tableau de données, dessine un graphe en segments ou en étoile où chaque ligne de x est représentée par une étoile et les colonnes par les longueurs des branches |
symbols(x, y, ...) |
dessine aux coordonnées données par x et y des symboles (cercles, carrés, rectangles, étoiles, thermomètres ou boxplots) dont les tailles, couleurs, etc, sont spécifiées par des arguments supplémentaires |
termplot(mod.obj) |
graphe des effets (partiels) d’un modèle de régression (mod.obj) |
12. Commandes du système d'exploitation
Il est possible de lancer, depuis R, des commandes appartenant au système d'exploitation (ici linux).
Cela peut-être utile en particulier pour demander l'exécution d'un programme externe, qui va lire/modifier/créer des fichiers dont les données pourront ensuite être exploitées par R.
ta=read.table("generated.tsv") # erreur, le fichier n'existe pas
system("/home/tludwig/master2ggb/generate_data.sh") #execution d'un programme qui genere des donnees
ta=read.table("generated.tsv") #maintenant le fichier existe
ta
r
Il est également possible de récupérer directement le résultat d'une commande.
existing=system("ls /home", intern=TRUE) #quels utilisateurs existent sur ce serveur ?
existing
loggedin=system("who | cut -d' ' -f1 | sort -u", intern=TRUE) #quels utilisateurs sont actuellement presents ?
loggedin
r
13. Import
Pour ne pas avoir à retaper sans cesse les mêmes commandes et réécrire les mêmes fonctions, il est possible de les stocker dans des fichiers (ex: monfichier.R) et de les charger en cas de besoin.
Dans ces fichiers, on pourra mettre des scripts (successions de commandes exécutées automatiquement) ou des fonctions que l'on a défini nous même et qui pourront être appelées quand nécessaire.
Il est également possible d'importer des librairies (ensemble de fichiers, publiquement disponibles) dans R.
Pour importer un fichier R, on utilise la fonction source(), tandis que pour importer des librairies, on utilise library()
library(ggplot2)
#chargement d'un script, qui s'execute
source("/home/tludwig/master2ggb/script.R")

#Error: could not find function "getdata"
d<-getdata()

#chargement du fichier qui contient la fonction
source("/home/tludwig/master2ggb/functions.R")
#maintenant la fonction est connue
d<-getdata()
d
r
14. which
Pour un vecteur logique (qui contient des valeurs TRUE/FALSE), la commande which donne les indices du vecteurs dont la valeur est TRUE :
#un vecteur qui contient chaque lettre de l'alphabet
LETTERS
#un vecteur qui contient TRUE si la lettre est "U"
LETTERS == "U"
#quelle est la position de U dans l'alphabet
which(LETTERS == "U")

#un vecteur qui contient les valeurs entre 1 et 150
1:150
#un vecteur qui contient TRUE si la valeur est multiple de 17
1:150 %% 17 == 0
#les multiples de 17 entre 1 et 150
which(1:150 %% 17 == 0)
r